Interessant: vor einiger Zeit habe ich mit einem damaligen Kollegen darüber gesprochen dass ich es unzumutbar kompliziert finde, ein Windows-System aktuell zu halten. Dabei bedeutet ‚aktuell‘ nicht nur dass man die neuesten Features nutzen kann, sondern insbesondere auch dass Sicherheitslöcher — die es heutzutage sogar in MP3-Abspielern und PDF-Betrachtern geben kann — gestopft werden.

Leider erwähnt es der Artikel nicht den Heise Gestern zu dem Thema veröffentlicht hat, daher schreibe ich es nochmal (falls der ehemalige Kollege oder sonstwer aus der Zielgruppe mitliest): Wo Windows-Anwender im Schnitt an 25 Stellen (die Zahl nennt der Artikel, die stammt offenbar von Secunia) nach Updates suchen müssen greifen Linux-Benutzer üblicherweise nur auf einem einzigen Weg auf ihre Software-Repositories zu. Debian-Benutzer geben beispielsweise nur apt-get update && apt-get upgrade ein und können sich sicher sein die letzten Pakete installiert zu haben die ihre Distribution ihnen bietet. Fertig. Grafische Benutzeroberflächen, insbesondere auf Mainstream-Systemen wie Ubuntu, bringen die Funktionalität grafisch. Da muss man weder selbst an den Check denken, noch das Kommando für das Update auswendig gelernt haben.

Insbesondere bei Sicherheitsrelevanten Updates sind eigentlich alle gängigen Linuxe ziemlich schnell. Ich persönlich habe ein gutes Gefühl bei der Sache.

Zwei Einwände hatte der Kollege seinerzeit noch:

  • Was ist mit Programmen die nicht von der Distribution gestellt werden? — Brot- und Butterprogramme wie Webbrowser, Office-Pakete oder Java-Laufzeitumgebungen bieten alle Distributionen. Braucht man eine spezielle Software findet man mit etwas Glück ein spezialisiertes Repository das man einfach einbinden kann. Gibt es auch das nicht bleibt einem wirklich nur die manuelle Installation. In dem Fall muss man aber nur ein einzelnes Programm manuell aktuell halten. Nicht alle (OK, fast alle). Wenn man mehrere Rechner versorgen will, beispielsweise in Unternehmen, spricht aber auch nichts dagegen sich ein eigenes Repo anzulegen. Schwer ist das nicht.
  • Datenschutz? Ist Dir egal dass $DISTRIBUTOR weiß was Du alles installiert hast? — Ja. Weil ich dem Hersteller meines Betriebssystems traue, sonst würde ich es nicht nutzen. Aber selbst wenn man das anders sieht: so ein Repository kann man auch komplett oder teilweise spiegeln, insbesondere in Unternehmen kann das schon allein deshalb sinnvoll sein damit nicht alle Pakete n mal übertragen werden müssen. Dementsprechend hat man in der Regel auch die Auswahl zwischen mehreren Repositories im Netz. Da kann man sich dann überlegen wem man das Vertrauen schenken möchte.

Alles in allem bleibe ich bei dem was ich damals schon gesagt habe: ständig auf der Jagd nach Updates zu sein wäre mir zu stressig. Und das würde ich insbesondere nicht-computeraffinen Benutzern nicht zumuten wollen. Denkt daran wenn Eure Eltern von Euch einen Computer eingerichtet haben wollen! ;-)

Schön finde ich übrigens, dass Heise in dem Artikel auf XKCD linkt. :-D

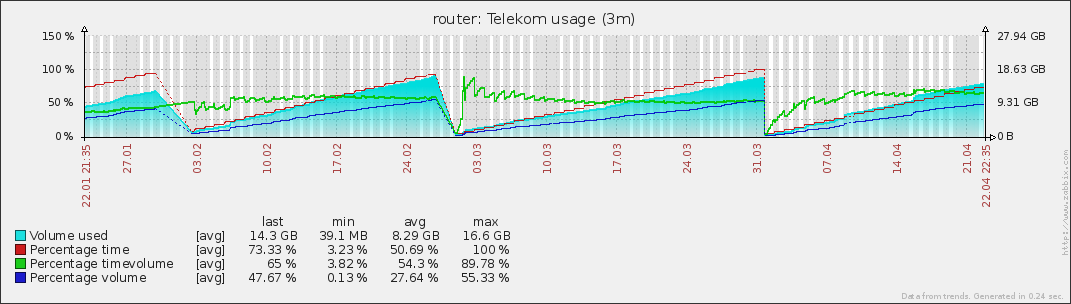
Drei Monate Telekom, wie Zabbix sie mir zeigt

Drei Monate Telekom, wie Zabbix sie mir zeigt

Aufreger des Tages (zu Recht, wie ich finde) ist ja wohl das Vorhaben der Telekom, Festnetztarife mit einer Volumenbegrenzung zu versehen. Ich kann nach wie vor kein DSL- oder Glasfaser-Kunde werden, daher hoffe ich einfach mal dass die genannten Volumina vereinheitlicht werden.

Bis Januar hatte ich im UMTS-Netz eine Drossel nach 10GB. Seit LTE kann ich ungestraft 30GB übertragen. Technisch gibt das LTE-Netz auf dem Land ’nur‘ 50MBit her (ja, ich jammere auch nicht mehr), ich habe aber den 100MBit-Vertrag gemacht da hier das Volumen größer ist.

Jetzt ist in der Ankündigung die Rede von 75GB bei 16MBit im Festnetz, das ist das kleinste Paket. Bei den 50MBit die ich technisch erreichen könnte wären es 200GB, bei den 100MBit für die ich bezahle sogar 300GB — locker eine Verzehnfachung.

Kriege ich die dann auch? :-)

(Wirklich verbraucht habe ich in der LTE-Zeit übrigens nie mehr als monatlich 16,6GB, und davon gehen allein etwa acht auf das Konto von Zabbix (ja, das könnte man volumensparender installieren — ist dann aber nicht mehr so cool für mich. ;-) ))

Das Wort Rubber-hose cryptanalysis habe ich in Chaosradio 186 aufgeschnappt, es ging um elektronische Schließsysteme:

Rubber-hose cryptanalysis (übersetzt Gummischlauch-Kryptoanalyse) ist ein Euphemismus, mit dem die Verwendung von Folter mit der Absicht, eine Person zur Herausgabe eines Kennworts oder Entschlüsselungsschlüssels zu bringen, bezeichnet wird. Obwohl sich der Ausdruck selbst ursprünglich von einer Foltermethode ableitet, bei der jemandem mit einem Gummischlauch wiederholt auf die Fußsohlen geschlagen wird, steht er hier stellvertretend für alle Arten möglicher Foltermethoden.

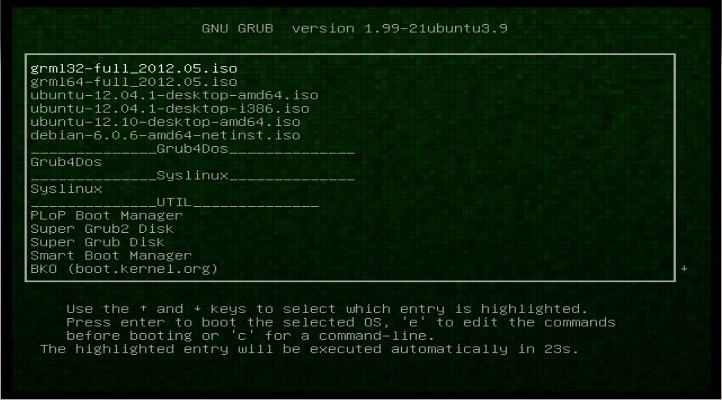
Gruselige Benutzeroberfläche

Gruselige Benutzeroberfläche

Vor einigen Jahren habe ich mal nach einer Möglichkeit gesucht, einen USB-Stick zu bauen mit dem man mehrere Boot-Images starten kann. Leider ohne Erfolg.

Ideal fände ich eine Lösung bei der ich nur noch ISO-Files auf den Stick legen muss, meinetwegen noch mit einem Skript das die ISOs dann beim Bootloader anmeldet. So etwas scheint es aber nicht zu geben, und das scheint mit den gängigen Bootloadern auch nicht ohne weiteres möglich zu sein.

Jetzt habe ich mir aber ein Programm angesehen das der Lösung zumindest nahe kommt: mit Multisystem kann man sich einen Stick erstellen von dem mehrere Systeme gebooted werden können.

Größter Haken beim Bau des individuellen Sticks ist dabei die Benutzeroberfläche. Von weitem sieht die zwar nett aus, damit zu arbeiten ist aber wirklich eine Herausforderung. Und damit meine ich nicht dass es eine steile Lernkurve gibt weil das Programm komplex ist, sondern schlicht weil die Oberfläche nichts taugt. Dass man die Größe der meisten Fenster nicht verändern kann ist dabei das kleinste Übel…

Das Ergebnis zählt

Das Ergebnis zählt

Aber mit einem kleinen HowTo — wie es sich zum Beispiel im Ubuntu-Wiki findet — kommt man doch zum Ziel. So habe ich jetzt einen kleinen aber stabilen 8GB-Stick (SanDisk Cruzer Pop) im Portemonnaie von dem ich wahlweise Ubuntu, einen Debian-Installer oder mein bevorzugtes ich-muss-was-machen-ohne-von-CD-zu-booten-System Grml starten kann. Letzteres wird nicht aktiv von Multisystem unterstützt, das hat erst Probleme gemacht: die 96-Bit-Variante (ja, Grml hat sowas! :-D) tut’s nicht, stattdessen habe ich jetzt die 32- und die 64-Bit-Version auf dem Stick. Kommt am Ende auf’s gleiche raus.

Multisystem ‚weiß‘ wie es die einzelnen ISOs behandeln muss um sie mit einem zentralen Bootloader starten zu können. Dazu ist für jedes unterstützte ISO eine Konfiguration hinterlegt, man kann dem Programm also auch nicht beliebige Systeme vor werfen. Die Ubuntu-Images liegen jetzt einfach als ISO auf dem Stick, ich weiss nicht ob ich die einfach austauschen könnte. Grml wird wie ein ‚richtiges‘ Debian behandelt und komplett ausgepackt auf den Stick gelegt. Der Traum vom Stick mit mehreren bootfähigen ISOs ist also immer noch nicht erfüllt.

Alternativ habe ich mir übrigens auch MultiCD angesehen, aber nicht wirklich ausprobiert. Wenn ich das richtig verstehe kann man damit nur CDs oder DVDs bauen, keine Sticks.

Falls doch noch jemand eine Idee hat wie man den Stick so bestücken kann wie ich mir das vorgestellt hatte: immer her damit!

130205_raspberryZwei Fliegen mit einer Klappe: vorhin habe ich erst meinen neuen Arduino darauf getrimmt, mittels eines DHT11 die Luftfeuchtigkeit und die Temperatur zu messen. Um das mal ein paar Tage zu beobachten habe ich das Ding jetzt an meinen — ebenfalls neuen — Raspberry Pi gehängt.

Den Raspberry hatte ich schon vor ein paar Tagen in Betrieb genommen. Das Betriebsssytemimage (Raspbian, ein spezielles Debian-Derivat) ist schnell von der Homepage heruntergeladen, entpackt und auf die SD-Karte installiert. Eigentlich dachte ich, dass ich einen Samstagabend mit der Inbetriebnahme totschlagen könnte, die ganze Aktion war aber nach zwanzig Minuten durch. Fast schon enttäuschend… :-)

Mit dem Arduino hat das Ding jetzt sein erstes kleines Ämtchen bekommen: es misst Temperatur und Luftfeuchtigkeit. Die Daten werden dann von meinem Zabbix gesammelt und bei Bedarf visualisiert.

Das ist erstmal nur eine Spielanwendung, das ist keine dauerhafte Installation. Dafür wäre das mit Kanonen auf Spatzen geschossen. Sowohl für den Raspberry als auch für den Sensor habe ich andere Pläne. Aber trotzdem finde ich es nett zu sehen, dass man sich auf die Weise schnell mal eine netzwerkfähige Sensorik zusammenbauen kann. Nett!

Heute habe ich mich (unter anderem) mit einem Problem beschäftigt das auf den ersten Blick trivial aussieht. Ich zumindest habe bislang keine Lösung gefunden die mir wirklich gefällt. Mal sehen ob was dabei rauskommt wenn ich das hier ‚crowdsource’… :-)

Aufgabenstellung: Zähle, wie viele Prozesse eines bestimmten Programmes schon länger als 30 Minuten laufen.

Klingt einfach, oder?

Die Ausgaben von ps zu parsen erscheint mir dabei aber zu fehleranfällig. Da müsste man zu viel berücksichtigen: Prozesse die vielleicht länger als einen Tag laufen, Prozesse die über Mitternacht gelaufen sind… ich habe nicht getestet wie es aussieht wenn man an der Zeitzone rumspielt… Nein, das kann nicht der richtige Ansatz sein.

Meine erste echte Lösung sieht zwar hässlich originell aus, funktionierte aber im Test (zu Demozwecken suche ich mal nach meinem Firefox):

echo | killall -i --older-than 30m firefox 2> /dev/null | tr -cd '?' | wc -c

Mit -i ist killall ‚interaktiv‘, fragt also zu jedem gefundenen Prozess freundlich nach ob es zuschlagen soll. Mit dem reingepipten echo beantwortet es sich diese Frage immer negativ. Der Rest der Zeile zählt im Prinzip wie oft killall gefragt hat ob es töten soll.

Blöd ist, dass die auf einem etwas älteren RHEL laufen soll. Anders als bei Ubuntu kennt killall da die Option –older-than noch nicht.

Der zweite Lösungsansatz funktioniert leider nur auf den ersten Blick, dafür aber auch auf dem alten Red Hat:

find /proc/[0-9]* -maxdepth 1 -name status -mmin +30 | xargs egrep "^Name:\sfirefox$" | wc -l

Ich suche also alle Prozesse die schon länger als 30 Minuten laufen, und suche in deren status-Datei nach dem Namen meines Prozesses. Die Ergebnisse werden dann wieder gezählt. Alternativ könnte man statt in der status- auch in der cmdline-Datei suchen, in meinem echten Einsatz übersehe ich damit dann auch Zombies (die werden separat betrachtet). Leider funktioniert dieser Ansatz nicht wirklich zuverlässig. Es sieht so aus als ob der Kernel den Dateien im Proc-Verzeichnis bisweilen einen neuen Timestamp gibt — obwohl der Prozess nicht gestartet oder beendet wurde. Ein Schuss in den Ofen, also. :-(

Wie macht man sowas? Ich meine, wenn man eine zuverlässige Lösung mit Bordmitteln haben will? Gibt es da ein passendes Tool das ich noch nicht kenne? Oder hilfreiche Optionen für gängige Tools? Wenn ich die Suchmaschine meiner Wahl frage finde ich eine Menge Lösungen, aber die sind entweder auch wackelig, oder sie bestehen darauf direkt alles zu töten…

Zwischendurch mal was nützliches für alle die — wie ich — viel in Unix-Shells unterwegs sind. Insbesondere für die die — wie ich — auch gerne mal ‚Einzeiler‘ schreiben die über mehrere Bildschirmzeilen gehen… :-)

Das Kommando fc steht für ‚fix command‘, damit wird die zuletzt ausgeführte Zeile zur Bearbeitung im Editor geöffnet. Also idealerweise im Vim. Da kann man komfortabel seine Änderungen vornehmen, direkt nach Beendigung des Editors wird das Kommando ausgeführt. Zumindest die Bash und die Zsh (letztere ist die interaktive Shell meiner Wahl) können das.

Ich persönlich kannte das vorher noch nicht. Hilfreich wäre es schon in wirklich vielen Situationen gewesen: ich neige wie gesagt dazu komplexe Shell-Zeilen zusammenzubauen. Wenn ich mit einem Ergebnis zufrieden bin schiebe ich es oft mittels echo in eine Datei, um die dann zum Shellskript umzuformen. Wenn ich mit fc eh in den Editor wechsele kann ich nicht nur von vornherein sauberer schreiben, sondern bei Bedarf mit ‚:w tollesskript.sh‘ direkt in eine Datei sichern.

Eigentlich ist es schade drum:

root:~# stat /var/log/installer.log.1 | grep Modify
Modify: 2002-12-03 21:03:20.000000000 +0100

Das Debian auf meinem Heimserver habe ich vor genau zehn Jahren, einem Monat, einem Tag und ein paar Stunden installiert. Vor einem halben Jahr habe ich das einem Arbeitskollegen erzählt, er hat es mir nicht geglaubt — vermutlich übersteigt das die wildesten Fantasien eines Windows-Admins… :-)
Wenn ich mich recht erinnere war das meine erste Debian-Installation überhaupt, vorher liefen da ein SuSE, ein Mandrake und ein Red-Hat Linux. Ich meine, mich auch noch dunkel an ein Halloween Linux erinnern zu können.
Damals müsste das eine Hardware in Pentium-Klasse gewesen sein, sicher nicht mehr als 166MHz. An den Speicher und die Festplatte kann ich mich nicht mehr erinnern.
Sicher ist es nicht weiter schwer, ein System zehn Jahre am Leben zu erhalten. Das Ding hat aber eine bewegte Geschichte hinter sich. Mal abgesehen davon dass es immer wieder auf neuere Hardware umgezogen ist hatte es im Laufe der Zeit schon folgende Funktionen:

  • Durchgehend hat es Basis-Dienste für mein Netz bereitgestellt: NFS, DNS (Bind), DHCP, Web (Apache)… sogar ein NIS lief da.
  • Kuriosester Einsatz war wohl der als Wecker: Weckzeit mit Barcode-Scanner programmiert, dann Wecken mit abwechseln MP3 und Zeitansage (Sprachsynthese mit Mbrola). :-D
  • Es war mal ein Fax-Server (Hylafax) und ein Drucker-Server (erst ohne, später mit Cups).
  • Es war mal ein Anrufbeantworter (Vbox3).
  • Es war mal ein Videorecorder (VDR). Seit der Server in den Keller gewandert ist habe ich im Wohnzimmer einen Festplattenlosen Rechner der per PXE vom Server booted.
  • Ursprünglich war nur eine Platte drin. Dann mal mehrere separate, dann RAID5, seit ein paar Jahren RAID1.
  • Da liefen mal Teile eines Konfigurationsvorschlags von der c’t, mit Virtualisierung einer Endian Firewall per UML (User Mode Linux).
  • Der nächste Virtualisierungsansatz hiess Xen, auch wieder mit einer Endian Firewall. Zusätzlich aber mit einer vierfach-Netzwerkkarte.
  • Irgendwann fand ich Endian doof, um das FreeBSD-basierte pfSense nutzen zu können habe ich Xen durch KVM ersetzt.
  • Und um die Sache spannender zu machen habe ich neben KVM auch Linux-Vserver eingesetzt.

Wohlgemerkt: alles ohne das Betriebssystem neu zu installieren! Das System habe ich Heute abgeschaltet, und so wie es aussieht endgültig. :-(

Nicht erschrecken: ich bin mit Debian als Serversystem mehr als zufrieden. Und nein, ich werde mein Heimnetz nicht abschalten. :-)

Aber die Grundlage wird eine andere. Ich hatte ja schon erwähnt dass mir Proxmox VE gut gefällt. Nicht zuletzt weil es auf Debian basiert. Hier und da gibt es Verbesserungspotential, aber im Moment scheint mir das für mich die beste Lösung zu sein.
Ich habe in den letzten zwei Wochen viel Zeit in den Umbau gesteckt. Proxmox auf der Umweltsau installiert, erst die KVM-Virtualisierten Systeme — zwei FreeBSD und ein Ubuntu — rübergeholt, dann die Vserver. Letztere mussten ja auch noch an OpenVZ angepasst werden.
Heute kam der finale Schritt: ich habe meinen Hauptserver virtualisiert. Also oben genanntes Debian-System. Das siecht jetzt erstmal als KVM vor sich hin. Noch macht es DNS, DHCP und Web, Backups der anderen Systeme, und ein paar andere Kleinigkeiten. Nach und nach werde ich es seiner Dienste berauben und dann wirklich entsorgen.
Aber vorher warte ich ein paar Tage ab ob die ganze Geschichte so auf dem neuen Server funktioniert. Wenn nicht kann ich die alte Kiste mit wenig Aufwand wieder anschalten. Wenn doch wird da auch ein Proxmox installiert, und ich migriere die ganzen virtuellen Maschinen zurück. Auf Dauer will ich die Umweltsau doch nicht 24/7 laufen lassen…

Pinball Dreams

Pinball Dreams

Die Reihe wird fortgesetzt: der Scripted Amiga Emulator tut genau was der Name vermuten lässt. Er emuliert einen Commodore Amiga. Und das im Browser, implementiert in JavaScript.
Technisch sind die Amigas in den 80ern zu Hause, trotzdem beeindruckt mich insbesondere auch dieser Emulator. Bei den Dingern ist nicht nur die CPU sauber nachzubauen, da vieles durch spezialisierte Bausteine realisiert wurde. Paula, Denise und Agnus. Das kostet natürlich Ressourcen… die Emulation läuft bei mir zumindest im Firefox gerade eben erträglich schnell. Angeblich bringt Chrome mehr, aber ich bin ein Gewohnheitstier…
Einen Amiga habe ich nie selbst gehabt, aber ich kann mich lebhaft an die eine oder andere Extreme Violence Session bei einem Freund erinnern… :-D

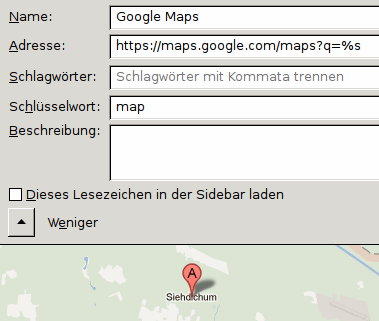
Geht auch in Google Maps

Geht auch in Google Maps

Einige werden die Funktion schon kennen, ich habe mal in einem Podcast davon gehört. Da wurde ein Firefox-Entwickler nach der seiner Meinung nach sinnvollsten Funktion gefragt die zu wenige Benutzer kennen. Das war eben diese Schlüsselwortsuche.
Ich gestehe dass ich Websuchen immer noch in Google durchführe. Im Firefox drücke ich also [Strg+k] und gebe direkt meine Suchbegriffe ein.
Wenn ich was anderes suchen möchte könnte ich natürlich die entsprechende Suchmaschine zu meinem Browser dazu konfigurieren und im Suchfeld mit [Strg+Pfeiltaste] das gewünschte aussuchen. Ich persönlich mag das nicht.
Schicker finde ich den Ansatz mit den Schlüsselwörtern: dazu rufe ich die Seite auf auf der ich suchen möchte. Wikipedia zum Beispiel. Im Suchfeld mache ich einen Rechtsklick und wähle „Ein Schlüsselwort für diese Suche hinzufügen…“. Das öffnet den Dialog mit dem ich ein Lesezeichen anlegen kann. Hier vergebe ich jetzt ein Schlüsselwort, beispielsweise ‚wp‘. Sinnigerweise habe ich diese Art von Lesezeichen in einem bestimmten Ordner versammelt, aber das ist Geschmackssache. In den Lesezeichen findet sich dann etwas in der folgenden Form:

http://de.wikipedia.org/w/index.php?search=%s&title=Spezial%3ASuche

Das ist die URL die durch die Suche angesprochen würde. Der Platzhalter %s markiert hier die Stelle an der der Suchbegriff stehen müsste. Wikipedia-Suchen mache ich jetzt einfach indem in ich mit [Strg-L] in die URL-Zeile springe und da etwas wie ‚wp hendiadyoin‘ ein und komme direkt auf der passenden Seite raus.
Das funktioniert mit den meisten Suchmaschinen, Shops oder sonstigen Webseiten. Lediglich Google Maps hat sich bislang dagegen gewehrt. Grund ist wohl die Art in der Maps arbeitet, durch den Parameter output=js kommt die Antwort in einem etwas speziellen Format. Ich habe gerade die URL des Lesezeichens für die Schnellsuche etwas eingedampft. So klappt es auch mit Google Maps:

http://maps.google.com/maps?q=%s

Jetzt gebe ich in der URL-Zeile einfach nur ‚map siehdichum‘ ein und sehe direkt wo der Ort mit diesem malerischen Namen liegt. :-)